
Conclusión principal: Los grandes modelos de lenguaje han acaparado la atención en el campo de la IA, pero se está gestando una revolución silenciosa: los modelos de lenguaje pequeños (SLM, por sus siglas en inglés) demuestran que la escala no lo es todo. Al centrarse en datos de alta calidad y arquitecturas eficientes, los SLM pueden igualar o incluso superar a modelos mucho más grandes en tareas específicas, además de ser más rápidos, económicos y preservar la privacidad. Para la mayoría de las aplicaciones empresariales y de consumo del mundo real, lo pequeño suele ser más inteligente.
El problema de los modelos gigantes
Los modelos de vanguardia como GPT-4 y PaLM-2 contienen cientos de miles de millones —a veces más de un billón— de parámetros. Sus capacidades son extraordinarias, pero presentan importantes inconvenientes. Requieren enormes centros de datos, consumen cantidades ingentes de electricidad y su entrenamiento y mantenimiento son costosos. Según un estudio de 2022 realizado por Hoffmann et al. en DeepMind, muchos modelos grandes están insuficientemente entrenados en relación con su tamaño, lo que significa que su rendimiento podría mejorarse con mejores datos en lugar de con más parámetros. Este hallazgo, conocido como las «leyes de escalado de la chinchilla», puso en entredicho la suposición de que los modelos más grandes son automáticamente mejores.
Las empresas y los desarrolladores también se enfrentan a obstáculos prácticos: costes de las API, latencia, dependencia de un proveedor y problemas de privacidad de datos. Enviar datos confidenciales de clientes a un megamodelo remoto puede resultar inaceptable para aplicaciones de salud, finanzas y derecho. Aquí es donde los modelos de lenguaje pequeños resultan fundamentales.
¿Qué son los modelos de lenguaje pequeños?
Los modelos de lenguaje pequeños suelen tener entre unos pocos millones y unos pocos miles de millones de parámetros, hasta 100 veces más pequeños que los modelos de lenguaje de vanguardia . Algunos ejemplos son Phi 3 Mini de Microsoft (3.8 millones de parámetros), Gemma de Google (2/7 millones), Llama 3.2 de Meta (1/1.1 millones) y TinyLlama de código abierto (3 millones). A pesar de su tamaño compacto, estos modelos son sorprendentemente capaces. Microsoft informa que Phi 3 Mini iguala o supera a modelos del doble de su tamaño en muchas pruebas de comprensión del lenguaje, gracias a datos de entrenamiento cuidadosamente seleccionados y de alta calidad, en lugar de la extracción indiscriminada de datos web.
Otro ejemplo es DistilBERT , una versión simplificada del modelo BERT de Google. Conserva el 97 % de la comprensión del lenguaje de BERT, siendo un 60 % más rápido y un 40 % más pequeño. Esto lo hace ideal para aplicaciones en tiempo real como la búsqueda y el análisis de sentimientos.
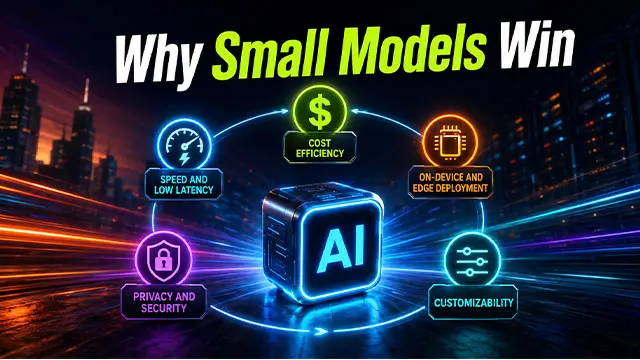
Por qué los modelos pequeños triunfan en el mundo real.
1. Rentabilidad
Los modelos pequeños pueden ejecutarse en una sola GPU o incluso en una CPU, lo que reduce drásticamente los costos de inferencia. Para una empresa que procesa millones de documentos diariamente, un modelo que cuesta centavos por millón de tokens es esencial. Una llamada a la API de un modelo LLM masivo podría costar entre 10 y 100 veces más para obtener el mismo resultado.
2. Velocidad y baja latencia
En chatbots, asistentes de programación y aplicaciones móviles, los usuarios esperan respuestas casi instantáneas. Los modelos pequeños generan tokens mucho más rápido que sus contrapartes gigantes, lo que los hace ideales para el uso interactivo.
3. Implementación en el dispositivo y en el borde
Esta es quizás la mayor ventaja. Los modelos pequeños pueden funcionar completamente en teléfonos inteligentes, computadoras portátiles y dispositivos integrados sin conexión a internet. Los modelos básicos de Apple y el Gemini Nano de Google son ejemplos de esta tendencia. Esto permite la traducción en tiempo real, asistentes sin conexión y una IA privada en el dispositivo que nunca envía datos a la nube.
4. Privacidad y seguridad
Al ejecutar el modelo localmente, los datos confidenciales —historiales médicos, documentos financieros, fotos personales— nunca salen del dispositivo. Esto supone un cambio radical para las industrias reguladas y los consumidores preocupados por su privacidad.
5. Personalización
Los modelos pequeños son más fáciles de ajustar con datos específicos del dominio. Un hospital puede ajustar un modelo 7B con sus propias notas clínicas, logrando una mayor precisión en tareas médicas que un modelo 175B de propósito general que sabe un poco de todo, pero nada específico.
El futuro: Especialización en lugar de sobredimensionamiento
Según un informe de Hugging Face de 2024 , las descargas de modelos pequeños de código abierto crecen más rápido que las de modelos grandes. La firma de análisis tecnológico Gartner predice que para 2027, más del 50 % de los modelos GenAI utilizados en las empresas serán específicos de un dominio, frente a menos del 1 % en 2023. Esto sugiere que el futuro de la IA no reside en un único cerebro gigante, sino en una red de modelos especializados y eficientes que trabajan conjuntamente.
Conclusión
El auge de los modelos de lenguaje pequeños marca la madurez de la industria de la IA. Si bien los modelos de vanguardia seguirán ampliando los límites de lo posible, el trabajo práctico de las empresas y la vida cotidiana será gestionado cada vez más por modelos más pequeños, rápidos y privados. En los próximos años, los ganadores serán quienes implementen el modelo adecuado para cada tarea, no necesariamente el más grande.